Să creezi o provocare de programare bună e mult mai greu decât pare. Dacă ai creat vreodată o provocare de cod, știi cât te chinui: să scrii un enunț clar, să faci teste de exemplu care te ghidează fără să dea răspunsul, să construiești teste ascunse care prind scurtăturile și să legi totul de o soluție de referință care să se potrivească perfect. Îți ia ușor câteva ore.
Am construit integrarea MCP a DojoCode ca să comprimăm acest proces de la ore la minute — păstrând totodată oameni cu experiență implicați acolo unde contează cel mai mult.
În acest articol îți arătăm cum funcționează, ce spun cercetările despre provocările și testele generate de AI și ce au crezut de fapt programatorii când au încercat-o.
Ce face integrarea MCP
Model Context Protocol (MCP) este un standard deschis pentru conectarea instrumentelor bazate pe AI la servicii externe. Nu e un plugin izolat, ci o capabilitate la nivel de protocol, suportată în mai multe medii — Claude Code, Cursor, VS Code cu Copilot, Gemini CLI și orice alt client compatibil MCP.
DojoCode pune la dispoziție un server MCP care te duce de la o idee formulată în limbaj natural la un pachet complet de provocare, gata de rulat, fără să ieși din IDE:
Descrie ce vrei
Spune-i asistentului AI ce fel de provocare îți trebuie — subiect, dificultate, limbaj.
MCP generează pachetul
Enunțul problemei, codul de pornire, testele de exemplu, testele ascunse de evaluare și o soluție de referință — produse prin apeluri structurate de instrumente.
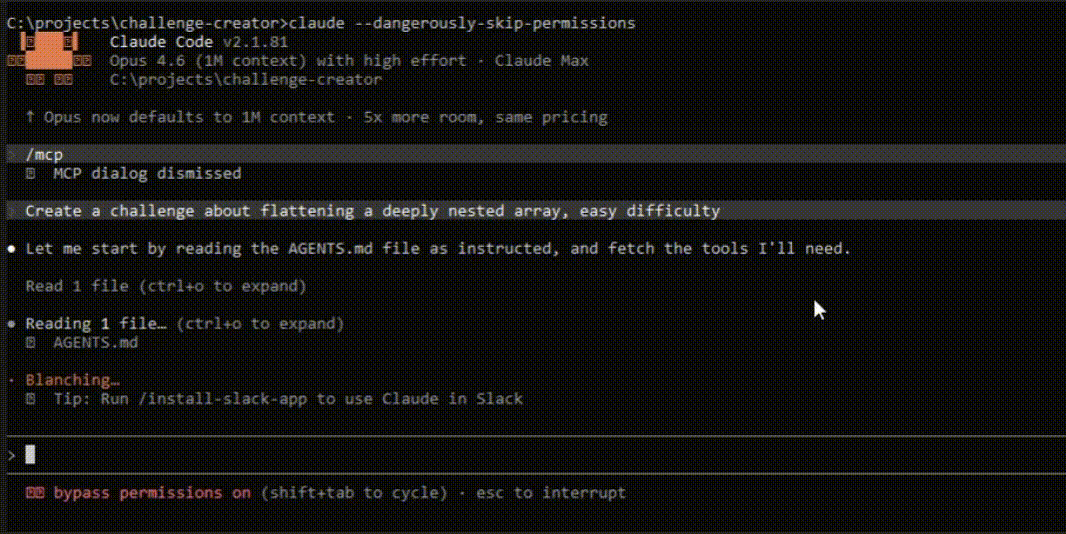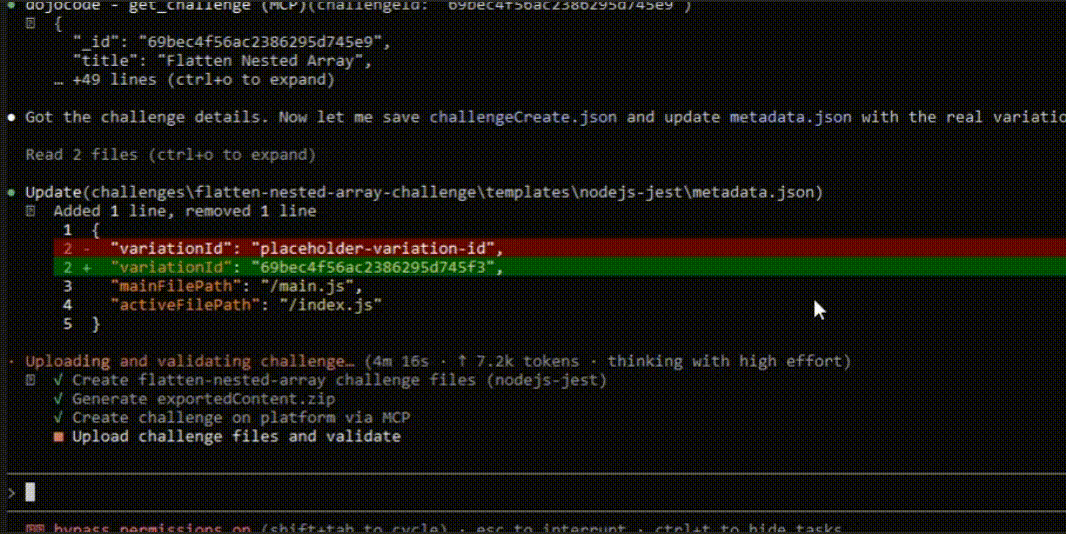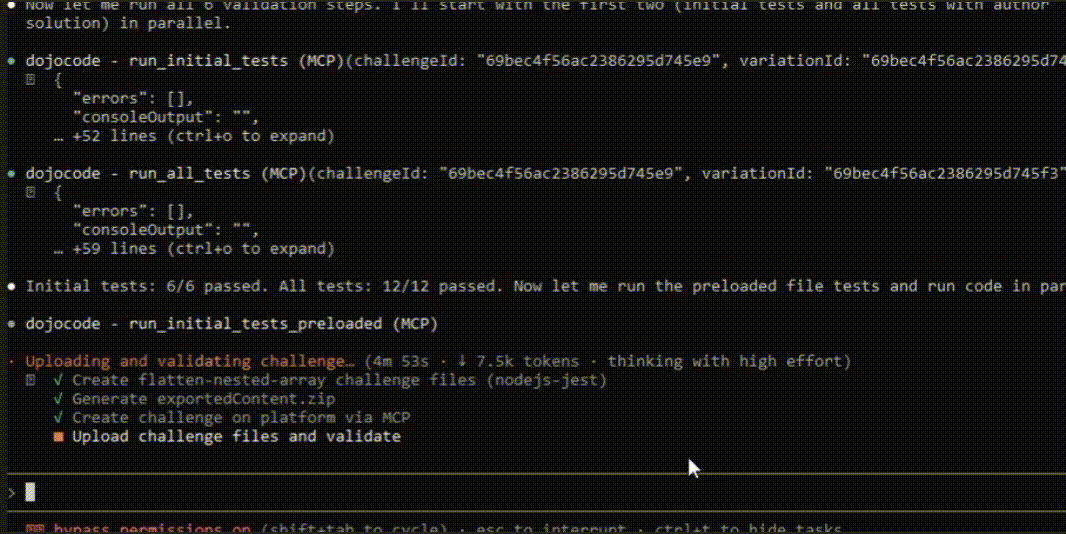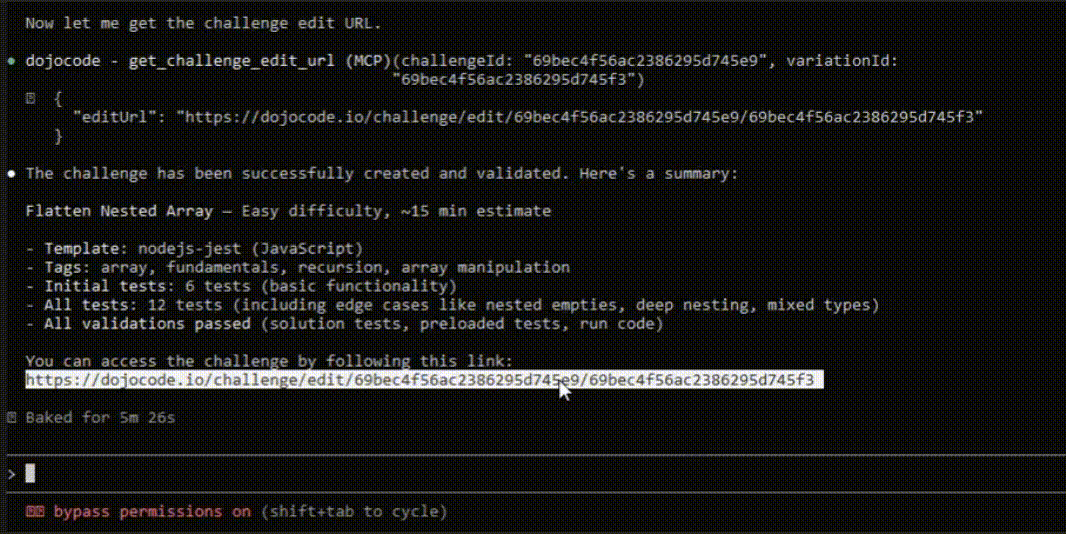
Validare automată
MCP rulează testele inițiale și testele complete de evaluare atât pe soluția de referință, cât și pe fișierele de pornire preîncărcate — automat, ca parte a fluxului de generare. Nu trebuie să rulezi manual niciun test.
Verifici, ajustezi, publici
Rafinezi ce e de rafinat și publici în mediul izolat (sandbox) al DojoCode.
Ce înseamnă de fapt „gata de producție”
O provocare de programare nu e un singur fișier — e o descriere, cod de pornire, teste de exemplu, teste ascunse și o soluție de referință, care trebuie să fie toate consecvente între ele. Pentru profesorii care evaluează dacă rezultatul generat de AI e suficient de bun pentru uz real, acestea sunt criteriile de calitate care contează:
Structura suitei de teste
Practica din industrie recomandă 2–3 teste de exemplu care clarifică intrările și ieșirile așteptate, plus 8–15 cazuri în total, care acoperă scenarii distincte — intrări goale, valori-limită, constrângeri de performanță, erori de tip off-by-one. Testele redundante, care verifică același comportament, adaugă zgomot fără valoare.
Diferența dintre „trece” și „e bun”
Un studiu din 2025 care a analizat cod generat de AI n-a găsit nicio corelație directă între trecerea testelor unitare și calitatea sau securitatea generală a codului. Testele verzi sunt necesare, dar nu suficiente — exact de aceea verificarea umană nu e opțională în acest flux.
Acoperire ≠ eficacitate
Odată ce ții cont de dimensiunea suitei, corelația dintre acoperirea codului și eficacitatea testelor este slabă spre moderată. Acoperirea scoate la iveală zonele netestate, dar dacă o tratezi ca țintă de calitate îți creează o încredere falsă. Ce contează e dacă testele prind soluțiile greșite — o chestiune de judecată, nu o metrică.
Ce ne spun programatorii
Am rugat câțiva programatori să încerce integrarea MCP: să genereze o provocare de la zero, să evalueze rezultatul și să ne spună sincer ce a mers și ce nu. Feedbackul a fost structurat pe criterii clare de evaluare — claritatea problemei, calitatea testelor, realismul pentru evaluare și timpul economisit.
Feedback complet →
Despre provocările de nivel senior: „Da, dar probabil trebuie să intervii și să verifici din nou, pentru că AI-ul s-ar putea să nu fie pe deplin capabil s-o facă singur.”
Riscuri: „Provocarea poate fi rezolvată de un alt AI pe care îl pot folosi utilizatorii.”
Caz de utilizare: Generarea de provocări personalizate pentru recrutare.
Ce se poate îmbunătăți: „README-ul ar putea fi mai clar și ar putea arăta un exemplu de prompt pentru AI.”
Feedback complet →
Prima impresie: „M-a impresionat cât de repede a ajuns de la idee la o provocare complet funcțională. Am spus doar «vino cu o provocare Vue 3 pentru începători» și mi-a propus mai multe variante.”
Ce l-a surprins: Instrumentul a tradus o singură provocare în toate cele 8 framework-uri frontend (Vue, VueTS, React, ReactTS, Svelte, VanillaJS, VanillaTS, Angular) dintr-o singură mișcare — cu sintaxa potrivită fiecărui framework, importuri corecte în teste și o structură de proiect corectă. S-a și corectat singur când testele au picat.
Despre provocările de nivel senior: „Da, cu prompturile potrivite. Dacă specifici tipare avansate precum mașini de stări, gestionarea concurenței sau componente de system design, poate genera provocări cu o complexitate pe măsură.”
Riscuri: „Generarea unor provocări prea asemănătoare cu problemele obișnuite în stil LeetCode, pe care candidații le-ar putea rezolva pentru că le recunosc, nu pe baza abilităților. Și buguri subtile în testele pentru cazurile-limită, care i-ar putea frustra pe candidați.”
Feedback complet →
Experiență: Peste 50 de interviuri pentru o companie de software, cu provocări găsite pe LeetCode sau create manual.
Ce l-a surprins: Cât de ușor e de folosit.
Despre enunțuri: „9/10 — poate unele formulări nu sunt chiar atât de prietenoase pentru începători.”
Ajustări manuale: Deocamdată nu, dar a observat că soluția propusă ar fi avut nevoie de câteva corecturi.
Despre provocările de nivel senior: „Absolut. LLM-urile pot crea cu ușurință provocări de nivel senior.”
Riscuri: „Niciun risc, însă un code review serios e necesar 100%.”
Caz de utilizare: Crearea de provocări pentru interviurile viitoare.
Să fim sinceri în privința limitelor
Dacă ești profesor sau mentor și te gândești să folosești asta în fluxul tău de lucru, iată pe scurt cum stau lucrurile:
Ce face bine automatizarea
- Schițarea rapidă a enunțurilor și a structurii testelor
- Iterarea rapidă pe variante de dificultate
- Cod de pornire și soluții în mai multe limbaje
- Suite de teste inițiale care acoperă scenariile comune
- Validarea automată a testelor pe soluție și pe codul de pornire
- Traducerea unei singure provocări în mai multe framework-uri
Unde judecata umană rămâne esențială
- Verificarea faptului că problema testează ce îți propui
- Validarea cazurilor-limită
- Validarea faptului că descrierea problemei e completă și clară
- Validarea faptului că descrierile testelor sunt complete și curate
- Calibrarea dificultății în funcție de publicul tău
- Asigurarea unei evaluări corecte și consecvente
Acest tipar nu e specific doar DojoCode. Cercetările despre generarea de teste cu LLM-uri la scară mare — inclusiv implementarea de către Meta a generării de teste ghidate de mutații pe mii de clase — arată constant același rezultat: generarea asistată de AI aduce valoare reală atunci când e însoțită de verificare și selecție umană.
Gata s-o încerci?
Clonează repository-ul de pornire, deschide-l în IDE-ul tău compatibil MCP și autentifică-te cu contul DojoCode. Ghidul complet de configurare acoperă fiecare mediu:
Instrumentele de creare a provocărilor sunt disponibile pentru abonații Premium, conturile Business și membrii comunității care au strâns peste 300 de puncte XP pe platformă.